경사하강법
재료공학도를 위한 수치해석
- 1. 학습 목표
- 2. 방정식에서 최적화 문제로
- 3. 기울기와 방향미분
- 4. 경사하강법
- 5. 학습률의 영향
- 6. Python 구현
- 7. 합금의 비용과 강도를 고려한 예제
- 8. 정리
- 9. 연습 문제
1. 학습 목표
이 자료에서 $[\boldsymbol A]$, $[\boldsymbol x]$는 행렬·벡터의 성분 배열을 뜻하며, 배열의 행렬곱은 $[\boldsymbol A][\boldsymbol x]$처럼 붙여 쓴다. 물리적 벡터·텐서의 단일수축은 $\cdot$로 표시한다.
이번 강의가 끝나면 다음을 할 수 있어야 한다.
- 다변수 함수의 기울기(gradient)를 계산하고 그 의미를 설명할 수 있다.
- 경사하강법(gradient descent)의 반복식을 유도할 수 있다.
- 학습률(step size)이 수렴에 미치는 영향을 설명할 수 있다.
- 경사하강법을 Python으로 구현하고 종료 조건을 설정할 수 있다.
- 경사하강법과 다변수 Newton 방법의 차이를 설명할 수 있다.
용어: 이 강의에서는 널리 쓰이는 명칭인 경사하강법을 사용한다. 영어로는 gradient descent, steepest descent, steepest gradient descent 등으로 불린다.
2. 방정식에서 최적화 문제로
지금까지는 주로 다음과 같은 방정식의 해를 구했다.
\[f(x)=0, \qquad [\boldsymbol A][\boldsymbol x]=[\boldsymbol b] \rightarrow [\boldsymbol A][\boldsymbol x] -[\boldsymbol b]=[\boldsymbol 0]\] \[\sum_{j=1}^n A_{ij} x_j - b_i = 0 \quad \text{ for } i=1,2,\dots,n\]이번에는 함수의 값이 가장 작아지는 위치를 찾는 최적화 문제(optimization problem)를 생각한다.
\[\min_{\boldsymbol x} F(\boldsymbol x)\]예를 들어, 일변수 함수
\[f(x)=(x-3)^2\]는 $x=3$에서 최솟값 $0$을 갖는다. 미분 가능한 함수가 내부점에서 최솟값을 가지면 일반적으로 다음 조건을 만족한다.
\[f'(x)=\frac{\partial f}{\partial x}=0\]변수가 여러 개라면 도함수 대신 기울기 벡터가 등장한다.
\[\nabla f(\boldsymbol x)=\boldsymbol 0\] \[\bigg(\frac{\partial f}{\partial x_1},\frac{\partial f}{\partial x_2},\frac{\partial f}{\partial x_3}\bigg)=(0,0,0)\]3. 기울기와 방향미분
-
$f(x,y)$의 기울기는 각 변수에 대한 편미분을 모은 벡터이다.
\[\nabla f(x,y) = \begin{bmatrix} \dfrac{\partial f}{\partial x} \\ \dfrac{\partial f}{\partial y} \end{bmatrix}\]예를 들어,
\[f(x,y)=(x-2)^2+2(y+1)^2\]이면
\[\nabla f(x,y) = \begin{bmatrix} 2(x-2) \\ 4(y+1) \end{bmatrix}.\] -
단위벡터 $\boldsymbol d$ 방향으로 조금 이동할 때 함수값의 변화율은 방향미분
\[D_{\boldsymbol d}f=\nabla f\mathbin{\cdot}\boldsymbol d\]
로 나타난다. Cauchy–Schwarz 부등식1에 따라 이 값은 $\boldsymbol d=-\nabla f/|\nabla f|_2$일 때 가장 작다2. 즉,
- $\nabla f$는 함수값이 가장 빠르게 증가하는 방향이다.
- $-\nabla f$는 함수값이 가장 빠르게 감소하는 방향이다.
- $\nabla f=\boldsymbol 0$이면 어느 방향으로도 일차적인 변화가 없다.
주의: $\nabla f=\boldsymbol 0$인 점은 최솟값뿐 아니라 최댓값이나 안장점(saddle point)일 수도 있다.
4. 경사하강법
-
$(k)$번째 스텝에서 위치 $\boldsymbol x^{(k)}$에서 함수값을 줄이기 위해 음의 기울기 방향으로 작게 이동한다.
\[\boldsymbol x^{(k+1)} =\boldsymbol x^{(k)}-\alpha_k\nabla f\left(\boldsymbol x^{(k)}\right)\]여기서 $\alpha_k>0$는 학습률, 보폭, 또는 step size라고 부른다.
4.1. 알고리듬
- 초기값 $\boldsymbol x^{(0)}$, 학습률 $\alpha$, 허용오차
tol, 최대 반복 횟수를 정한다. - 현재 위치에서 기울기 $\boldsymbol g^{(k)}=\nabla f(\boldsymbol x^{(k)})$를 계산한다.
- $|\boldsymbol g^{(k)}|_2<\text{tol}$이면 계산을 종료한다.
- $\boldsymbol x^{(k+1)}=\boldsymbol x^{(k)}-\alpha\boldsymbol g^{(k)}$로 갱신한다.
- 2–4단계를 반복한다.
-
함수값의 변화나 위치의 변화를 추가 종료 조건으로 사용할 수도 있다.
\[\left|f(\boldsymbol x^{(k+1)})-f(\boldsymbol x^{(k)})\right|<\text{tol}\] \[\left\|\boldsymbol x^{(k+1)}-\boldsymbol x^{(k)}\right\|_2<\text{tol}\]
4.2. 손으로 계산하는 예제
- 다음 함수의 최솟값을 찾아보자.
-
기울기는
\[\nabla f(x,y)= \begin{bmatrix} \dfrac{\partial f}{\partial x} \\ \dfrac{\partial f}{\partial y} \end{bmatrix} = \begin{bmatrix} 2(x-2) \\ 4(y+1) \end{bmatrix}\]이다. 초기값을 $(x^{(0)},y^{(0)})=(0,1)$, 학습률을 $\alpha=0.2$로 정한다.
-
첫 번째 반복 $(k=1)$
\[\nabla f(0,1)= \begin{bmatrix}-4\\8\end{bmatrix}\] \[\begin{bmatrix}x^{(1)}\\y^{(1)}\end{bmatrix} = \begin{bmatrix}0\\1\end{bmatrix} -0.2\begin{bmatrix}-4\\8\end{bmatrix} = \begin{bmatrix}0.8\\-0.6\end{bmatrix}.\] -
두 번째 반복 $(k=2)$
\[\nabla f(0.8,-0.6)= \begin{bmatrix}-2.4\\1.6\end{bmatrix}\] \[\begin{bmatrix}x^{(2)}\\y^{(2)}\end{bmatrix} = \begin{bmatrix}0.8\\-0.6\end{bmatrix} -0.2\begin{bmatrix}-2.4\\1.6\end{bmatrix} = \begin{bmatrix}1.28\\-0.92\end{bmatrix}.\] -
반복할수록 $(x,y)$는 최솟점 $(2,-1)$에 가까워진다.
5. 학습률의 영향
-
학습률은 경사하강법의 성능을 크게 좌우한다.
- 너무 작으면 안정적이지만 수렴이 매우 느리다.
- 적절하면 함수값을 빠르게 줄일 수 있다.
- 너무 크면 최솟점을 지나치며 진동하거나 발산할 수 있다.
-
일변수 이차함수
\[f(x)=\frac{1}{2}ax^2, \qquad a>0\]에 경사하강법을 적용하면
\[x^{(k+1)}=x^{(k)}-\alpha g^{(k)}\]where $g^{(k)}=\nabla f(x^{(k)})$
thus \(x^{(k+1)}=x^{(k)}-\alpha ax^{(k)} =(1-\alpha a)x^{(k)}\)
이다. 따라서 수렴하려면
\(|1-\alpha a|<1\) 위 조건은 아래 둘을 만족해야 한다.
\[1-\alpha a < 1\ \ \Longrightarrow \alpha > 0\]그리고
\[1-\alpha a > -1\ \ \Longrightarrow \alpha < \frac{2}{a}\]따라서, \(0<\alpha<\frac{2}{a}\)
이어야 한다. 다변수 이차함수에서는 가장 큰 고윳값(eigenvalue)이 안전한 학습률의 범위를 결정한다. 실제 문제에서는 작은 고정 학습률로 시작하거나, 반복마다 함수값이 감소하도록 $\alpha_{(k)}$를 조절하는 선 탐색(line search)을 사용할 수 있다.
6. Python 구현
먼저 목적함수와 기울기를 정의한다.
import numpy as np

def objective(x,y):
    """F(x, y) = (x - 2)^2 + 2(y + 1)^2"""
    return (x - 2.0)**2 + 2.0*(y + 1.0)**2

def gradient(x, y):
    return np.array([
        2.0*(x - 2.0),
        4.0*(y + 1.0),
    ])
다음 함수는 반복 과정도 함께 저장한다.
def gradient_descent(grad, x0, alpha=0.2, tol=1e-8, max_iter=1000):
    x = np.asarray(x0, dtype=float).copy()
    history = [x.copy()]

    for iteration in range(max_iter):
        g = grad(x[0],x[1])

        if np.linalg.norm(g) < tol:
            return x, np.array(history), iteration

        x = x - alpha*g
        history.append(x.copy())

    raise RuntimeError("최대 반복 횟수 안에 수렴하지 않았습니다.")

x_min, history, n_iter = gradient_descent(
    gradient,
    x0=[0.0, 1.0],
    alpha=0.2,
)

print("minimum point:", x_min)
print("function value:", objective(*x_min))
print("iterations:", n_iter)
수렴 경로를 등고선 위에 그려보자.
import matplotlib.pyplot as plt

x_grid = np.linspace(-0.5, 2.5, 200)
y_grid = np.linspace(-1.5, 1.5, 200)
X, Y = np.meshgrid(x_grid, y_grid)
Z = (X - 2.0)**2 + 2.0*(Y + 1.0)**2

plt.contour(X, Y, Z, levels=20)
plt.plot(history[:, 0], history[:, 1], "o-", color="tab:red")
plt.plot(2.0, -1.0, "k*", markersize=12, label="minimum")
plt.xlabel("x")
plt.ylabel("y")
plt.axis("equal")
plt.legend()
plt.show()
같은 함수와 수렴 경로를 3차원 곡면 위에 나타내면 경사하강법이 함수값을 줄여가는 과정을 더욱 직관적으로 확인할 수 있다.
fig = plt.figure(figsize=(9, 7))
ax = fig.add_subplot(111, projection="3d")

# 목적함수의 3차원 곡면
surface = ax.plot_surface(
    X,
    Y,
    Z,
    cmap="viridis",
    alpha=0.75,
    edgecolor="none",
)

# 각 반복점에서의 함수값
z_history = np.array([objective(*point) for point in history])

# 곡면에 가려지지 않도록 경로를 조금 위에 표시한다.
z_offset = 0.02*Z.max()
ax.plot(
    history[:, 0],
    history[:, 1],
    z_history + z_offset,
    "o-",
    color="tab:red",
    linewidth=2,
    markersize=4,
    label="gradient descent",
)

ax.scatter(2.0, -1.0, z_offset, color="black", marker="*", s=120,
           label="minimum")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_zlabel("F(x, y)")
ax.set_title("Gradient descent on a 3D objective surface")
ax.view_init(elev=30, azim=-55)
fig.colorbar(surface, ax=ax, shrink=0.6, pad=0.1, label="F(x, y)")
ax.legend()
plt.show()
곡면을 반투명한 격자(mesh)로 강조하고 싶다면 plot_surface 대신 다음 코드를 사용할 수 있다.
ax.plot_wireframe(X, Y, Z, rstride=8, cstride=8,
                  color="tab:blue", alpha=0.5)
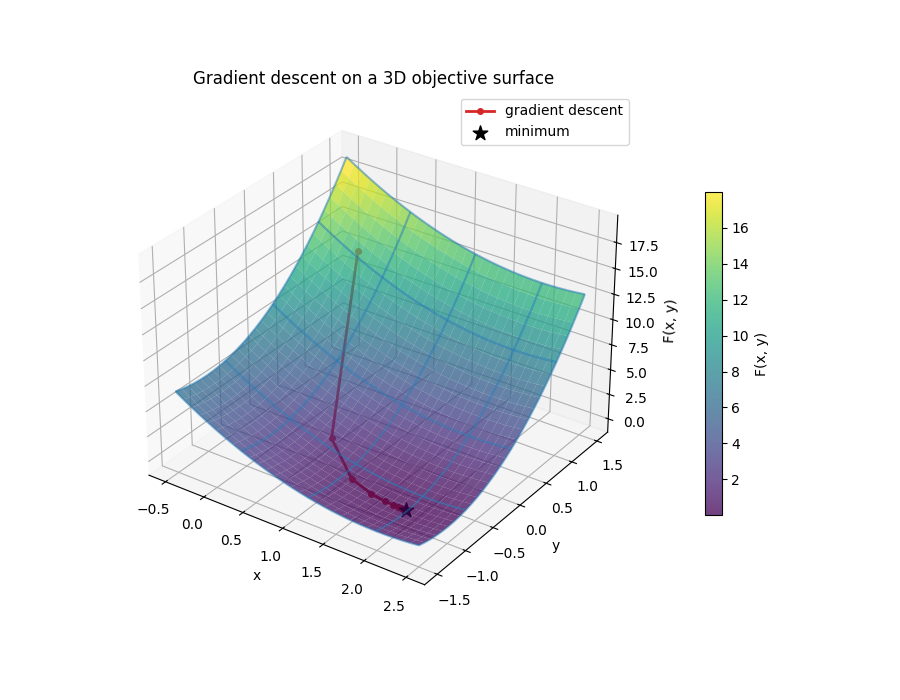
-
alpha를0.02,0.2,0.49,0.51로 바꾸어 경로와 수렴 여부를 비교해보자.
7. 합금의 비용과 강도를 고려한 예제
7.1. 합금 설계 문제
서로 다른 두 재료 A와 B를 혼합하여 새로운 합금을 만든다고 가정하자. 재료 B의 질량분율을 $x$라고 하면 재료 A의 질량분율은 $1-x$이다.
\[0\leq x\leq1\]다음 값은 경사하강법을 설명하기 위한 교육용 가상 데이터이다. 실제 합금의 강도는 조성뿐 아니라 상(phase), 열처리, 결정립 크기 및 시험조건에도 영향을 받으므로 단순한 혼합법칙을 그대로 적용할 수 없는 경우가 많다.
| 재료 | 비용 (천 원/kg) | 강도 (MPa) |
|---|---|---|
| 합금 A | 2 | 300 |
| 합금 B | 10 | 700 |
혼합에 따른 비용 $C(x)$와 강도 $S(x)$가 질량분율에 따라 선형적으로 변한다고 단순화하자.
\[\begin{aligned} C(x)&=2(1-x)+10x=2+8x,\\ S(x)&=300(1-x)+700x=300+400x. \end{aligned}\]합금 B의 양을 늘리면 강도는 증가하지만 비용도 증가한다. 따라서 강도만 최대화하면 $x=1$을 선택하게 되고, 비용만 최소화하면 $x=0$을 선택하게 된다. 두 요구사항 사이의 균형을 나타내는 목적함수가 필요하다.
7.2. 목적함수 만들기
목표 강도를 $S_{\mathrm{target}}=500\ \mathrm{MPa}$로 정하자. 목표 강도와의 차이 및 비용을 함께 고려하여 다음 목적함수를 사용한다.
\[\boxed{ F(x) =\left(\frac{S(x)-500}{100}\right)^2 +0.2\left(\frac{C(x)}{10}\right)^2 }\]첫 번째 항은 목표 강도와의 차이에 대한 벌점이고, 두 번째 항은 비용에 대한 벌점이다. 강도는 MPa, 비용은 천 원/kg으로 단위가 다르므로 각각 $100$과 $10$으로 나누어 크기를 비슷하게 만들었다. 이 과정을 정규화 (normalization)라고 한다.
계수 $0.2$는 비용의 상대적인 중요도를 나타내는 가중치(weight)이다.
- 가중치가 작으면 목표 강도에 가까워지는 것을 더 중요하게 생각한다.
- 가중치가 크면 비용 절감을 더 중요하게 생각한다.
$S(x)=300+400x$와 $C(x)=2+8x$를 대입하면
\[F(x)=(4x-2)^2+0.2(0.2+0.8x)^2\]이고, 도함수는
\[\begin{aligned} \frac{dF}{dx} &=8(4x-2)+0.32(0.2+0.8x)\\ &=32.256x-15.936 \end{aligned}\]이다.
7.3. 경사하강법 적용
초기 조성을 $x^{(0)}=0.20$, 학습률을 $\alpha=0.03$으로 정하면 반복식은
\[x^{(k+1)} =x^{(k)}-0.03\left(32.256x^{(k)}-15.936\right)\]이다.
첫 번째 반복에서는
\[\begin{aligned} \frac{dF}{dx}(0.20)&=-9.4848,\\ x^{(1)}&=0.20-0.03(-9.4848)=0.484544 \end{aligned}\]를 얻는다. 두 번째 반복에서는
\[\begin{aligned} \frac{dF}{dx}(0.484544)&\approx-0.3065,\\ x^{(2)}&\approx0.484544-0.03(-0.3065) =0.49374 \end{aligned}\]가 된다. 반복하면 $x\approx0.494$로 수렴한다.
전체 계산은 다음과 같이 구현할 수 있다.
def cost(x):
    return 2.0 + 8.0*x


def strength(x):
    return 300.0 + 400.0*x


def objective(x, cost_weight=0.2):
    strength_error = (strength(x) - 500.0)/100.0
    normalized_cost = cost(x)/10.0
    return strength_error**2 + cost_weight*normalized_cost**2


def objective_gradient(x, cost_weight=0.2):
    strength_error = (strength(x) - 500.0)/100.0
    normalized_cost = cost(x)/10.0

    # dS/dx=400, dC/dx=8이다.
    return (
        2.0*strength_error*(400.0/100.0)
        + 2.0*cost_weight*normalized_cost*(8.0/10.0)
    )


x = 0.20
alpha = 0.03

for iteration in range(100):
    gradient_value = objective_gradient(x)

    if abs(gradient_value) < 1e-8:
        break

    x = x - alpha*gradient_value

    # 조성의 물리적 범위 0 <= x <= 1을 유지한다.
    x = min(1.0, max(0.0, x))

print(f"B의 질량분율 = {x:.4f}")
print(f"A의 질량분율 = {1.0 - x:.4f}")
print(f"예측 강도 = {strength(x):.1f} MPa")
print(f"예측 비용 = {cost(x):.2f} 천 원/kg")
예상되는 출력은 다음과 같다.
B의 질량분율 = 0.4940
A의 질량분율 = 0.5060
예측 강도 = 497.6 MPa
예측 비용 = 5.95 천 원/kg
7.4. 결과 해석
목표 강도가 정확히 $500\ \mathrm{MPa}$가 되려면 $x=0.5$가 필요하다. 그러나 목적함수에는 비용 항도 포함되어 있으므로, 계산 결과는 합금 B를 조금 덜 사용하는 $x\approx0.494$가 된다. 그 결과 비용은 조금 감소하고 강도는 목표보다 약간 낮아진다.
비용 가중치를 바꾸면 설계 결과도 달라진다.
for weight in [0.0, 0.2, 1.0, 5.0]:
    x = 0.20

    for iteration in range(1000):
        gradient_value = objective_gradient(x, cost_weight=weight)

        if abs(gradient_value) < 1e-8:
            break

        x = x - 0.02*gradient_value
        x = min(1.0, max(0.0, x))

    print(
        f"weight={weight:3.1f}, x={x:.4f}, "
        f"strength={strength(x):.1f} MPa, "
        f"cost={cost(x):.2f} 천 원/kg"
    )
이 예제에서 min과 max는 반복 중 $x$가 물리적인 조성 범위 $[0,1]$을 벗어나지 않도록 되돌리는 역할을 한다. 이러한 방법을 투영 경사하강법 (projected gradient descent)의 간단한 형태로 볼 수 있다.
이 예제의 선형 강도식은 알고리듬 학습을 위한 단순 모델이다. 실제 합금 설계에서는 실험 데이터로부터 얻은 회귀모델이나 물리 기반 모델을 사용하고, 밀도·내식성·가공성 및 조성 제한도 함께 고려해야 한다.
8. 정리
- 기울기(gradient)는 함수가 가장 빠르게 증가하는 방향을 나타낸다.
- 경사하강법은 음의 기울기 방향(기울기의 반대 방향)으로 반복하여 이동한다.
- 학습률은 수렴 속도와 안정성을 결정한다.
- 종료 조건은 기울기의 크기, 위치의 변화, 함수값의 변화 등을 이용해 정한다.
- 서로 다른 단위의 성능 지표를 한 목적함수에서 비교할 때는 정규화와 가중치를 사용할 수 있다.
9. 연습 문제
- $f(x,y)=x^2+4y^2-2x+8y$의 기울기와 해석적 최솟점을 구하라.
- 초기값 $(2,2)$와 학습률 $\alpha=0.1$을 사용하여 위 함수에 경사하강법을 세 번 적용하라.
- 같은 문제에서 $\alpha=0.01$, $0.1$, $0.3$일 때 함수값의 변화를 비교하라.
-
다음 행렬과 벡터로 정의한 이차함수에 경사하강법을 적용하라.
\[f([\boldsymbol x]) =\frac{1}{2}[\boldsymbol x]^{\mathsf T}[\boldsymbol A][\boldsymbol x] -[\boldsymbol b]^{\mathsf T}[\boldsymbol x]\] \[[\boldsymbol A]= \begin{bmatrix}4&1\\1&3\end{bmatrix}, \qquad [\boldsymbol b]= \begin{bmatrix}1\\2\end{bmatrix}.\]구한 결과를
np.linalg.solve(A, b)와 비교하라. -
합금 비용·강도 예제에서 $x=0.3$일 때 비용 $C(x)$와 강도 $S(x)$를 계산하라.
-
비용 가중치를 $0.0$, $0.2$, $1.0$으로 바꾸어 최적 조성, 강도 및 비용을 비교하고 가중치의 영향을 설명하라.
-
Cauchy–Schwarz 부등식: 임의의 두 벡터 $\boldsymbol a$와 $\boldsymbol b$에 대하여 $|\boldsymbol a\mathbin{\cdot}\boldsymbol b| \leq |\boldsymbol a|_2|\boldsymbol b|_2$가 성립한다. 두 벡터 사이의 각을 $\theta$라고 하면 $\boldsymbol a\mathbin{\cdot}\boldsymbol b =|\boldsymbol a|_2|\boldsymbol b|_2\cos\theta$이므로, 이 부등식은 $-1\leq\cos\theta\leq1$이라는 사실로 이해할 수 있다. 특히 $|\boldsymbol d|_2=1$일 때 $\nabla F\mathbin{\cdot}\boldsymbol d$의 최솟값은 $-|\nabla F|_2$이며, $\boldsymbol d=-\nabla F/|\nabla F|_2$일 때 얻어진다. 따라서 음의 기울기는 함수값이 국소적으로 가장 빠르게 감소하는 방향이다. ↩
-
2-norm: 벡터 $\boldsymbol x$의 2-norm은 $|\boldsymbol x|_2=\sqrt{x_1^2+x_2^2+\cdots+x_n^2}$로 정의된다. 2-norm은 벡터의 길이를 나타내며, $|\boldsymbol x|_2=0$이면 $\boldsymbol x=\boldsymbol 0$이다. ↩